

Оформление заказа
Вы ищете решение:

Выберите свой вариант, и мы составим для вас наиболее выгодное
предложение


Observability в IPTV: які метрики має бачити оператор, щоб швидко знаходити проблеми
Для IPTV/OTT-оператора стабільність сервісу визначається не лише доступністю серверів і каналів. Платформа може працювати без критичних помилок, CDN – успішно передавати відеопотік, а користувачі при цьому стикатимуться з тривалим запуском трансляції, буферизацією або відмовою в доступі до контенту. Якщо моніторинг показує лише стан інфраструктури, технічна команда дізнається про такі проблеми від абонентів.
Масштаб цього завдання підтверджують дані 2026 року. Згідно з Bitmovin Video Developer Report 2026/27, підготовленим на основі відповідей 486 фахівців із 94 країн, лише 9% команд знаходять першопричину проблем зі стримінгом менш ніж за годину. У 29% пошук займає від 12 до 24 годин. Водночас 28% респондентів називають постійний моніторинг та аналітику однією з головних галузевих проблем, а 27% – пошук першопричин збоїв.
Для оператора це означає, що недостатньо просто збирати більше технічних даних. Потрібно пов’язати стан серверів, роботу middleware, доставку відео та дії користувача в єдину картину. Саме це завдання розв’язує observability – спостережуваність IPTV/OTT-сервісу.
Чим observability відрізняється від звичайного моніторингу
Класичний моніторинг відповідає на заздалегідь визначені запитання: чи доступний сервер, скільки ресурсів він використовує, чи працює API, чи не перевищено допустимий рівень навантаження. Це необхідно, але не завжди допомагає пояснити, чому в конкретної групи абонентів перестав запускатися телеканал.
Observability дає змогу досліджувати поведінку всієї системи на основі метрик, журналів подій і даних про проходження запитів між компонентами. Важливо не лише виявити відхилення, а й простежити зв’язок між його причиною та результатом, який бачить глядач.
Наприклад, скарга «канал не відкривається» може означати різні проблеми. У користувача закінчилася підписка, пристрій не пройшов авторизацію, middleware видало некоректне посилання, DRM-сервер відмовив у ліцензії або CDN не зміг доставити сегмент. Симптом один, але відповідальні компоненти та дії технічної команди відрізняються.
Тому спостережуваність потрібно будувати навколо повного користувацького сценарію: вхід у застосунок, перевірка прав, отримання списку каналів, вибір контенту, запуск потоку та подальше відтворення. На кожному етапі оператору потрібні власні показники.
Метрики користувацького досвіду: що відбувається під час перегляду
Перший рівень observability – якість відтворення, або QoE (Quality of Experience). Ці дані показують не те, що інфраструктура мала надати, а те, що фактично отримав користувач.
Оператору насамперед потрібні показники успішності запуску відео, часу до першого кадру, частоти та тривалості буферизації, помилок відтворення та фактично використовуваного бітрейту.
Час запуску відео слід вимірювати від дії користувача до появи першого кадру. Корисно відстежувати не лише середнє значення, а й 95-й перцентиль: він показує час, у межах якого запускаються 95% виміряних сеансів. Це дає змогу виявляти проблеми, які приховуються за прийнятним середнім показником.
Помилки запуску та відтворення необхідно розрізняти. У першому випадку користувач взагалі не зміг почати перегляд. У другому трансляція запустилася, але згодом перервалася. Для діагностики це різні сценарії з потенційно різними причинами.
Буферизацію оцінюють за часткою сеансів із зупинками, кількістю зупинок і співвідношенням часу буферизації до тривалості перегляду. Додатково корисно бачити, чи знижується бітрейт під час сеансу. Якщо адаптивний плеєр постійно перемикається на низьку якість, відсутність зупинок ще не означає, що сервіс працює добре.
У дослідженні Bitmovin 2026 року буферизація та частота помилок виявилися найпоширенішими метриками QoE, які відстежуються: їх назвали відповідно 57% і 43% респондентів.
Ці показники особливо важливі в розрізі моделей приставок, версій застосунків, операційних систем, регіонів, інтернет-провайдерів і конкретних каналів. Загальна статистика може виглядати нормально, навіть якщо нова версія застосунку створює проблеми для значної частини користувачів однієї моделі пристрою.
При цьому точні показники буферизації, декодування та фактичної якості мають надходити з плеєра або клієнтського застосунку. За журналами центрального сервера неможливо надійно відновити все, що відбувалося на екрані абонента.
Авторизація та middleware: де починається збій
Другий рівень – керування доступом і робота серверної платформи. Навіть повністю справна система доставки відео не допоможе користувачеві, якщо він не зміг увійти в застосунок, отримати список каналів або підтвердити права на перегляд.
Тут оператору необхідно відстежувати кількість успішних і невдалих авторизацій, затримку обробки запитів, помилки API, активні сеанси, стан інтеграції з білінгом і результати перевірки тарифних обмежень.
Особливо важлива динаміка помилок. Наприклад, різке зростання відмов в авторизації після зміни тарифів може вказувати не на несправність пристроїв, а на помилку в налаштуваннях пакетів або синхронізації із зовнішньою системою.
CDN і сервери доставки: як визначити джерело проблем із потоком
Третій рівень observability охоплює шлях відео від центрального сервера до користувацького пристрою. Тут необхідно бачити не лише загальний обсяг трафіку, а й поведінку окремих компонентів доставки.
Для центрального сервера важливі завантаження процесора, пам’яті, дискової підсистеми та мережевих інтерфейсів, кількість запитів, час відповіді та частота помилок. Для CDN – вихідний трафік, частка запитів, обслужених із кешу, помилки отримання сегментів, затримки відповіді та розподіл навантаження між вузлами.
Особливо важливо розрізняти помилки центрального сервера та CDN. Якщо користувачі одного регіону масово стикаються з буферизацією, а в інших регіонах трансляція працює стабільно, причиною може бути конкретний периферійний вузол або мережевий маршрут. Якщо ж помилки виникають у всіх регіонах одночасно, необхідно перевірити центральну інфраструктуру доставки, джерела відео та спільні залежності.
За використання кількох стримерів також слід контролювати доступність потоків на кожному сервері, кількість активних сеансів і результати балансування навантаження.
Ministra PRO підтримує перевірку доступності телеканалів на серверах мовлення та балансування навантаження між ними. За використання кількох серверів платформа може показувати результати перевірки доступності каналу, допомагаючи технічній команді визначити можливе джерело проблеми: посилання на потік, сервер мовлення або налаштування розподілу навантаження. Для аналізу стану CDN, завантаження мережевих інтерфейсів і передавання відеосегментів оператору необхідно доповнювати дані middleware інформацією із систем моніторингу відповідних компонентів інфраструктури.
Як пов’язати метрики та швидко знайти першопричину
Головна цінність observability розкривається, коли оператор може зіставляти дані різних компонентів в одному часовому інтервалі.
Для кожної події корисно зіставляти час виникнення, ідентифікатор сеансу, акаунт або знеособлений ідентифікатор користувача, пристрій, версію застосунку, канал, адресу потоку та сервер доставки. Якщо архітектура дозволяє, запитам між middleware, API та зовнішніми сервісами присвоюють спільний ідентифікатор трасування.
Це суттєво скорочує обсяг ручної роботи. Замість послідовного перегляду кількох незалежних журналів інженер отримує можливість відновити ланцюг подій, що передували помилці.
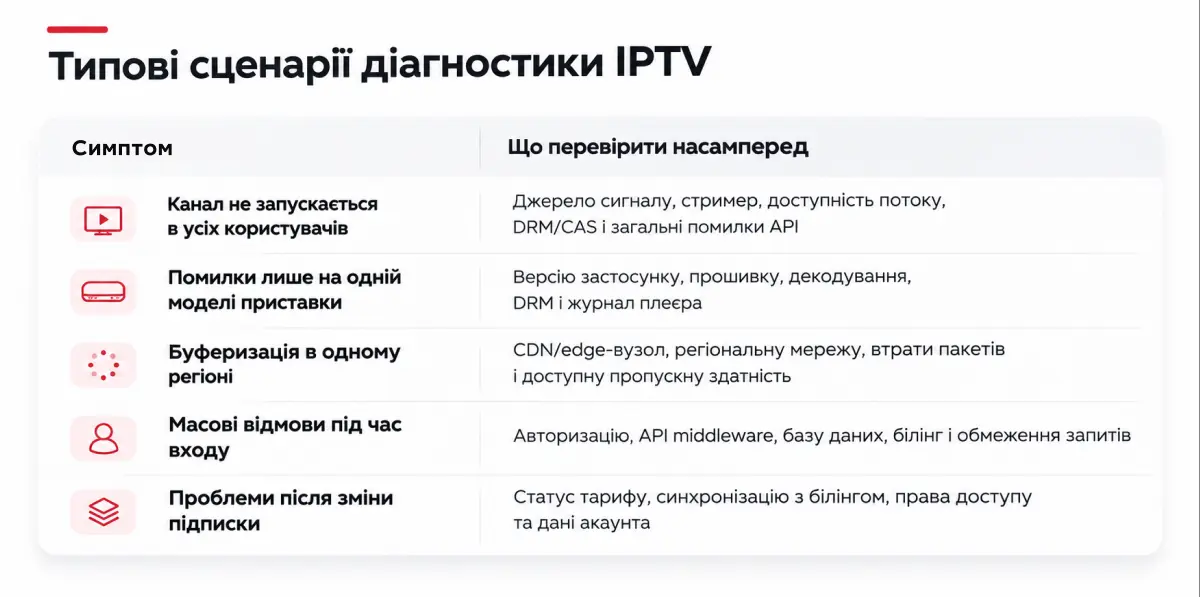
Це початкові напрями перевірки, а не автоматичне визначення першопричини. Остаточний висновок має підтверджуватися подіями та метриками.
Наприклад, після оновлення застосунку частка помилок запуску збільшилася лише на приставках із певною версією прошивки. Загальна доступність серверів при цьому залишається нормальною. Завдяки розподілу метрик за моделями пристроїв і версіями ПЗ команда може локалізувати проблему на клієнтському рівні, не витрачаючи час на перебудову CDN.
Інший приклад: під час футбольного матчу одночасно збільшуються час запуску каналів і кількість помилок авторизації. Якщо при цьому зростає затримка відповідей middleware API, а пропускна здатність CDN залишається в нормі, першочергова перевірка має стосуватися серверної платформи та пов’язаних із нею сервісів, а не відеоінфраструктури.
Яким має бути робочий екран оператора
Observability не потребує розміщення сотень графіків на одній панелі. Операційній команді потрібен екран, який дає змогу за кілька секунд визначити масштаб проблеми, а потім перейти до деталей.
Мінімальний набір показників для основної панелі можна розділити на шість груп:
- Аудиторія: активні сеанси, одночасні глядачі, розподіл за каналами, регіонами та пристроями.
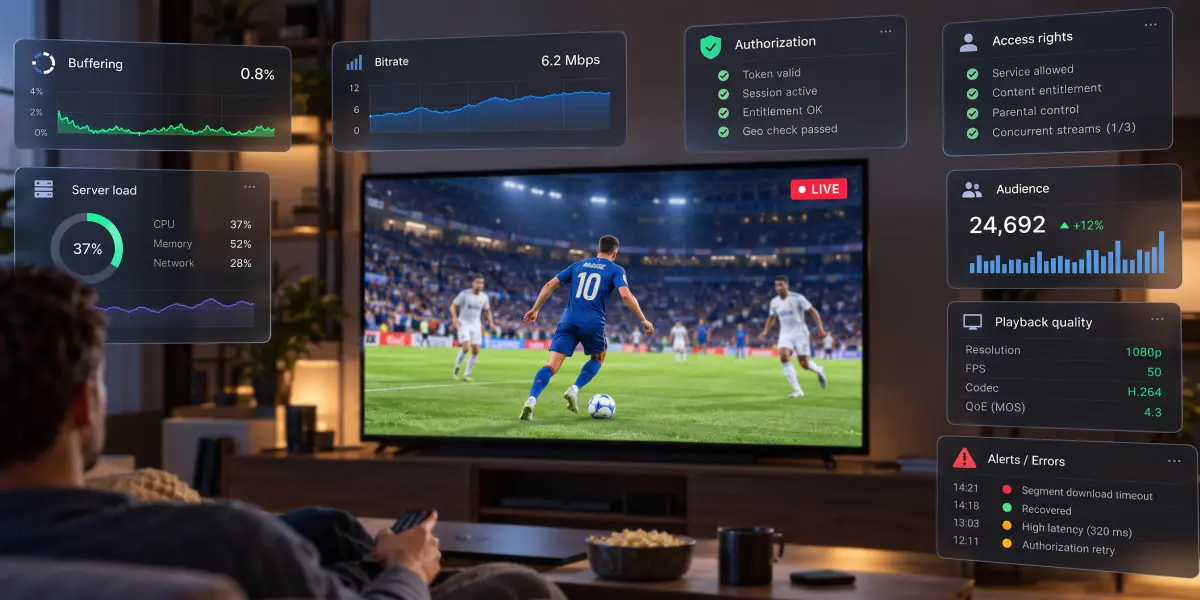
- Відтворення: успішність запуску, час до першого кадру, помилки плеєра, частота буферизації та фактичний бітрейт.
- Доступ: успішність авторизації, помилки middleware API, затримки відповідей і збої інтеграції з білінгом.
- Доставка: доступність потоків, стан стримерів, навантаження на CDN, помилки сегментів і частка запитів із кешу.
- Інфраструктура: завантаження серверів і баз даних, стан мережевих каналів і доступність ключових компонентів.
- Реагування: активні інциденти, звернення до підтримки, час виявлення та тривалість усунення.
Важливо, щоб показники можна було фільтрувати за часом, регіоном, каналом, застосунком і моделлю пристрою. Без цього загальна панель показує стан сервісу, але не завжди дає змогу дослідити конкретну проблему.
Окрему увагу слід приділити попередженням. Система має реагувати насамперед на відхилення, які справді впливають на перегляд: збільшення помилок запуску, зростання буферизації, недоступність популярного каналу або масові відмови в авторизації.
Порогові значення не можна однаково застосовувати до всіх сервісів. Для локального IPTV-оператора, готельної мережі та великої OTT-платформи нормальні показники навантаження відрізняються. Тому попередження налаштовують за історичними значеннями та цільовими вимогами до якості, а потім коригують за підсумками реальних інцидентів.
Як впроваджувати observability без зайвих витрат
Починати варто не з придбання ще однієї системи моніторингу, а з перевірки того, які дані оператор уже збирає.
Спочатку потрібно скласти карту основних користувацьких операцій і визначити, які компоненти беруть участь у кожній із них. Потім перевірити, де вже існують журнали подій і метрики, а на яких етапах інформація відсутня.
Наприклад, middleware може фіксувати початок перегляду та помилку плеєра, але не показувати причину проблем з отриманням відеосегментів. CDN знає про затримки доставки, але не має повних даних про тариф користувача. Система білінгу фіксує зміну підписки, але не обов’язково бачить її результат на клієнтському пристрої. Завдання observability – пов’язати ці джерела, а не замінити їх однією платформою.
Наступний крок – вибрати кілька критичних сценаріїв: масова авторизація, запуск популярного телеканалу, відтворення VoD, перемикання між каналами та відновлення після втрати з’єднання.
Для кожного сценарію слід заздалегідь визначити нормальну поведінку, необхідні показники, джерела даних і порядок діагностики. Після цього можна налаштувати спільні панелі та попередження.
Результат впровадження краще оцінювати не кількістю зібраних метрик, а операційними показниками: часом виявлення проблеми (MTTD), часом відновлення сервісу (MTTR), часткою інцидентів, виявлених до звернення абонентів, і кількістю повторюваних помилок.
Observability в IPTV – це можливість пов’язати технічний стан платформи з реальним досвідом глядача. Для оператора важливі не окремі графіки завантаження серверів, а розуміння того, де саме переривається шлях від входу в застосунок до стабільного перегляду. Ministra PRO допомагає контролювати користувацькі події, доступ до контенту, стан каналів і роботу сервісної логіки. У поєднанні з телеметрією плеєрів, CDN, стримерів і мережі ці дані дають змогу швидше локалізувати збої, точніше визначати відповідальних за усунення проблеми та скорочувати час відновлення сервісу.
Recommended
Чому RDK стає однією з ключових платформ операторського ТБ
Вибір платформи інтерактивного ТБ визначає не лише зовнішній вигляд меню та доступні застосунки. Від нього залежить, наскільки складно підключати нові моделі приставок, оновлювати програмне забезпечення, усувати несправності та змінювати постачальників обладнання. Для оператора й інтегратора це питання вартості та керованості сервісу протягом усього строку експлуатації.

ШІ в IPTV/OTT без хайпу: де він справді корисний оператору, а де поки заважає
Штучний інтелект уже використовується у відеосервісах для рекомендацій контенту, аналізу поведінки глядачів, автоматизації обробки відео та технічної діагностики. Але для IPTV/OTT-оператора цінність ШІ визначається не кількістю впроваджених алгоритмів, а результатами: чи допомагає він утримувати абонентів, підвищувати прибутковість тарифів, ефективніше використовувати контент і скорочувати операційні витрати.
Створення партнерської мережі: як розширювати присутність middleware у регіонах
Для IPTV-оператора middleware давно перестало бути лише технічним ядром сервісу. Це рівень, через який оператор керує користувачами, пристроями, тарифами, каналами, VoD, EPG, правами доступу, подіями, інтеграцією з білінгом і клієнтськими додатками. Тому поширення middleware в нових регіонах рідко зводиться до прямих продажів ліцензій. На практиці зростання частіше відбувається через партнерську мережу: інтеграторів, локальних дистриб’юторів, реселерів, сервісні компанії, консультантів з IPTV/OTT і постачальників суміжної інфраструктури.